Uke 5 – hva overlever gjentatt matrisemultiplikasjon?
Ukens spørsmål: hva overlever når vi ganger med den samme matrisen om og om igjen?
Tenk deg at du bruker den samme lineære transformasjonen på en vektor, igjen og igjen. Vektoren blir kanskje lengre, men hva skjer med retningen? Denne uken oppdager vi at noen helt spesielle retninger, egenvektorene, tar over. Og vi skal se at akkurat den samme ideen kan rangere nettsider ut fra lenkene mellom dem. Det er ideen bak Googles PageRank.
- En retning vokser fram: et forsøk der du ser én retning ta over.
- Finn de spesielle retningene: egenverdier og egenvektorer, regnet for hånd.
- Basis og gjentakelse: hvorfor den største egenverdien vinner, og spektralteoremet.
- Potensmetoden: en algoritme som finner den dominerende retningen, og Rayleigh-kvotienten.
- PageRank og en felle og en utvei: rangering som gjentatt matrisemultiplikasjon.
Etter uken skal du kunne forklare gjentatt multiplikasjon med bidrag langs egenvektorer, bruke potensmetoden og Rayleigh-kvotienten, og regne ut en PageRank-fordeling for et lite nettverk.
To deler: hente fram og bygge videre
| Matematikk 1 – dette henter vi fram | Matematikk 3A – dette bygger vi nå |
|---|---|
| Løse lineære likningssett; finne egenverdier og egenvektorer. Håndregning i 5.2. | Forklare gjentatt multiplikasjon med bidrag langs egenvektorer, og undersøke når én retning dominerer. Forsøk i 5.1, teori i 5.3–5.4. |
| Bruke \((A-\lambda I)v=0\) til å finne alle egenvektorene til en egenverdi. | Knytte egenvektorbasis til tidligere arbeid med basis og ortogonalitet, og bruke dette i potensmetoden og PageRank (5.3–5.6). |
Du trenger ikke huske regneoppskriftene før første forsøk. Vi henter dem fram i håndeksempelet i 5.2. Oppgavene i 5.8 Hovedløp bruker ukens nye ideer. 5.7 Støtteløp gir repetisjon av lineære systemer, egenverdier og egenvektorer ved behov. Du trenger ikke gjøre hele støtteløpet før hovedløpet.
Vi starter med et forsøk, ikke med en definisjon. Matrisen
\[A=\begin{bmatrix}2&1\\1&2\end{bmatrix}\]
beskriver en lineær transformasjon \(T(x)=Ax\) av planet. Hva skjer hvis vi bruker den samme transformasjonen igjen og igjen på en startvektor?
Lengden vokser fort, så figuren deler på lengden etter hvert steg. Å normalisere betyr å dele en vektor på lengden sin, slik at den får lengde én. Da ser vi bare retningen. Den oransje pilen er startvektoren \(x_0\), den blå er vektoren \(x_k\) etter \(k\) steg. Målet er å finne ut om ulike startvektorer ender i samme retning, og om noen retninger aldri endrer seg i det hele tatt.
Eksperiment 1 – hvilken retning blir igjen?
- Velg (1, 0) og trykk Ett steg fem ganger. Hvilken linje nærmer den blå pilen seg?
- Velg (−1, 0) og deretter (0, 1). Samme linje? Samme orientering?
- Velg (1, 1) og (1, −1). Endres retningen i det hele tatt? Prøv til slutt (1, −0.9), som ligger nær \((1,-1)\).
Hva viser forsøket? For mange startvektorer nærmer de normaliserte vektorene \(x_k\) seg samme linje, gjennom \((1,1)^T\). Fra \((1,0)\) og \((-1,0)\) havner pilen på samme linje, men med motsatt orientering. Med startvektor langs \((1,1)^T\) eller \((1,-1)^T\) endres retningen ikke i det hele tatt. Fra \((1,-0.9)\), som ligger nær \((1,-1)^T\), beveger pilen seg likevel bort og ender også på linjen gjennom \((1,1)^T\). Nå undersøker vi hva transformasjonen gjør langs disse to spesielle linjene.
Vi samler multiplikasjon og normalisering i én oppdateringsregel:
\[F(x)=\frac{Ax}{\lVert Ax\rVert_2},\qquad x_{k+1}=F(x_k).\]
Her er \(\lVert x\rVert_2\) vektorens vanlige lengde, og \(k\) teller stegene. Regelen er definert når \(Ax\ne0\).
Etter \(k\) steg er \(x_k=A^kx_0/\lVert A^kx_0\rVert_2\), med \(A^0=I\): normaliseringene underveis forkortes bort (se fordypningen under).
Diskuter: Hvorfor kan vi miste informasjon om lengde og likevel se hvilken retning som dominerer etter gjentatt transformasjon? Hva skiller de to spesielle startvektorene?
Gå i dybden: skaler uten å dreie
Kjenner dere igjen formen fra uke 2? Da sendte vi et tall inn i en regel og brukte svaret som neste verdi. Hva er likt nå, og hva er annerledes? Hvilken likning må en vektor oppfylle hvis neste steg skal gi akkurat samme vektor? Vi svarer i 5.4.
For startvektoren \((1,0)^T\) er første steg helt konkret
\[Ax_0=\begin{bmatrix}2\\1\end{bmatrix},\quad \lVert Ax_0\rVert_2=\sqrt5,\quad x_1=\frac1{\sqrt5}\begin{bmatrix}2\\1\end{bmatrix}.\]
Sjekk: Regn ut hva som skjer med \((1,1)^T\) og \((1,-1)^T\). Blir vektorene dreid, eller blir de bare ganget med et tall?
For \(x=(a,b)^T\) gir rad-ganger-kolonne-regelen
\[Ax=\begin{bmatrix}2a+b\\a+2b\end{bmatrix},\qquad \lVert Ax\rVert_2=\sqrt{(2a+b)^2+(a+2b)^2}.\]
Vi deler begge koordinatene på det samme positive tallet. Derfor bevares forholdet mellom koordinatene og orienteringen, og vektoren får lengde én.
Fra \(x_0=(1,0)^T\) får vi
\[x_1=\frac{(2,1)^T}{\sqrt5},\qquad Ax_1=\frac{(5,4)^T}{\sqrt5},\qquad \lVert Ax_1\rVert_2=\frac{\sqrt{41}}{\sqrt5}.\]
Dermed forkortes den tidligere normaliseringen bort:
\[x_2=\frac{(5,4)^T/\sqrt5}{\sqrt{41}/\sqrt5} =\frac{(5,4)^T}{\sqrt{41}} =\frac{A^2x_0}{\lVert A^2x_0\rVert_2}.\]
Den samme forkortingen skjer ved hvert steg, og den forklarer formelen i figuren. Vi utfører små, normaliserte steg; vi trenger ikke beregne hele \(A^k\) eksplisitt. Formelen forutsetter at nevnerne er ulike null.
Uten normalisering er de første resultatene \((1,0)^T,(2,1)^T,(5,4)^T,(14,13)^T\). Koordinatforskjellen er hele tiden én, men forskjellen blir liten relativt til størrelsen. Derfor nærmer retningen seg linjen \(x_2=x_1\). Her betyr \(x_1,x_2\) i linjelikningen koordinater, mens indeksen \(k\) i \(x_k\) ovenfor teller steg.
Ved valget \((1,-1)\) bruker figuren \(x_0=(1,-1)^T/\sqrt2\). Da er \(Ax_0=x_0\) allerede for startvektoren. Dette er et viktig unntak fra observasjonen om linjen \(x_2=x_1\), som vi forklarer i 5.2–5.3.
Matematikk 1: hent fram egenverdier og egenvektorer. Her repeterer vi betydningen og regnemetoden, med full håndregning i håndeksempelet.
Fra geometrisk observasjon til algebra
I figuren i 5.1 forble alle itererte vektorer på samme linje som startvektoren når denne lå langs \((1,1)^T\) eller \((1,-1)^T\). Figuren normaliserte lengden etter hvert steg. Nå spør vi: Hva gjør transformasjonen langs disse linjene før vi normaliserer?
Vi tar den geometriske observasjonen «samme linje» og skriver den som algebra: resultatet \(T(x)\) er et tall ganger startvektoren \(x\), altså \(T(x)=\lambda x\) for et tall \(\lambda\) og en startvektor \(x\ne0\). Siden \(T(x)=Ax\), blir dette \(Ax=\lambda x\). For \(A=\begin{bmatrix}2&1\\1&2\end{bmatrix}\) får vi
\[A\begin{bmatrix}1\\1\end{bmatrix}=3\begin{bmatrix}1\\1\end{bmatrix}, \qquad A\begin{bmatrix}1\\-1\end{bmatrix}=1\begin{bmatrix}1\\-1\end{bmatrix}.\]
Den ene retningen strekkes med faktor 3; den andre har faktor 1. Hva kunne normaliseringen i figuren skjule? Vi bruker observasjonen til å formulere en likning, og bruker så regning til å finne både strekkfaktorene og alle vektorene som oppfyller likningen.
Matematikk 3A: hvorfor nærmer iterasjonsfølgene seg samme linje fra ulike startvektorer? I 5.1 valgte vi startvektoren \(x_0=(1,0)^T\). Ved gjentatt anvendelse av transformasjonen \(T(x)=Ax\), med normalisering etter hvert steg, nærmet vektorene \(x_k\) seg linjen gjennom \((1,1)^T\). I 5.2 fant vi de to egenretningene. Nå bruker vi dem til å dele startvektoren i to bidrag og følge hvert bidrag når transformasjonen gjentas.
Med \(v_1=(1,1)^T\) og \(v_2=(1,-1)^T\) kan startvektoren bygges slik:
\[x_0=\begin{bmatrix}1\\0\end{bmatrix} ={\color{#1565c0}\underbrace{\tfrac12\begin{bmatrix}1\\1\end{bmatrix}}_{c_1v_1}} +{\color{#a04a00}\underbrace{\tfrac12\begin{bmatrix}1\\-1\end{bmatrix}}_{c_2v_2}}.\]
Etter \(k\) anvendelser av transformasjonen, før normalisering, er bidragene
\[{\color{#1565c0}b_1(k)=c_1\,3^k v_1},\qquad {\color{#a04a00}b_2(k)=c_2\,1^k v_2},\qquad A^kx_0=b_1(k)+b_2(k).\]
Ved hvert steg tredobles lengden til \(b_1(k)\), mens \(b_2(k)\) beholder lengden. For å se hvilket bidrag som bestemmer retningen, regner cellen ut hvor stor andel hvert bidrag har av summen av de to lengdene:
\[{\color{#1565c0}a_1(k)= \frac{\lVert b_1(k)\rVert_2}{\lVert b_1(k)\rVert_2+\lVert b_2(k)\rVert_2}}, \qquad {\color{#a04a00}a_2(k)= \frac{\lVert b_2(k)\rVert_2}{\lVert b_1(k)\rVert_2+\lVert b_2(k)\rVert_2}}.\]
Nevneren er summen av de to lengdene, ikke lengden av summen \(b_1(k)+b_2(k)\). For \(c_1=c_2=1/2\) starter begge andelene på \(1/2\), og de summerer alltid til 1. Målet er å se hvilket av de to bidragene som tar over, og om det andre bidraget virkelig forsvinner.
Eksperiment 2 – hvilken del tar over?
- Kjør med
c1 = c2 = 0.5. Blir det oransje bidraget kortere, eller blir det bare mindre sammenlignet med det blå? - Sett deretter
c1 = 0.0og beholdc2 = 0.5. Nå mangler bidraget langs \(v_1\) i startvektoren. Kan \(b_1(k)\) bli ulik null?
Hva viser forsøket? Den oransje andelen går mot null, men den oransje lengden er hele tiden den samme. Bidraget langs \((1,-1)^T\) forsvinner altså ikke. Det blir bare lite sammenlignet med bidraget langs \((1,1)^T\), som tredobles i hvert steg. Er \(c_1=0\), forblir det blå bidraget null: uten et bidrag langs den dominante egenvektoren fra start kan det ikke vokse fram.
Skriv observasjonen som algebra
Linearitet betyr at transformasjonen virker på hvert bidrag for seg: \(A(c_1v_1+c_2v_2)=c_1Av_1+c_2Av_2\). Hvert steg ganger hvert bidrag med sin egenverdi én gang; vi lar potensene stå synlige:
\[\begin{aligned} Ax_0&=\tfrac12{\color{#1565c0}3}\,v_1+\tfrac12{\color{#a04a00}1}\,v_2=(2,1)^T,\\ A^2x_0&=\tfrac12{\color{#1565c0}3^2}\,v_1+\tfrac12{\color{#a04a00}1^2}\,v_2=(5,4)^T,\\ A^3x_0&=\tfrac12{\color{#1565c0}3^3}\,v_1+\tfrac12{\color{#a04a00}1^3}\,v_2=(14,13)^T. \end{aligned}\]
Den oransje koeffisienten er hele tiden \(\tfrac12\), mens den blå tredobles.
Fra dette eksemplet til teorien
En basis (uke 3) lar oss skrive enhver vektor entydig som en sum av bidrag langs basisvektorene. Hvis egenvektorene \(v_1,\ldots,v_n\) er en basis, og \(c_i\) er startvektorens koeffisient i retning \(v_i\), får vi
\[x_0=\sum_{i=1}^n c_iv_i, \qquad A^kx_0=\sum_{i=1}^n c_i\lambda_i^kv_i.\]
Matrisen kalles da diagonaliserbar. Egenverdien \(\lambda_1\) er dominant når \(|\lambda_1|>|\lambda_i|\) for alle \(i>1\). Hvis \(c_1\ne0\), vokser bidraget langs den tilhørende egenvektoren relativt til de andre. Forholdet \(|\lambda_2/\lambda_1|\), med egenverdiene sortert etter absoluttverdi, forklarer farten etter mange steg: er forholdet nær én, tar det lang tid før den dominerende retningen tar over.
Gå i dybden: hvorfor kan vi behandle bidragene hver for seg?
Over skrev vi \(Ax_0\), \(A^2x_0\) og \(A^3x_0\) som summer langs \(v_1=(1,1)^T\) og \(v_2=(1,-1)^T\): i hvert steg får hvert bidrag en ny faktor, \(3\) langs \(v_1\) og \(1\) langs \(v_2\). Etter \(k\) steg er
\[A^kx_0=\tfrac12{\color{#1565c0}3^k}\begin{bmatrix}1\\1\end{bmatrix} +\tfrac12{\color{#a04a00}1^k}\begin{bmatrix}1\\-1\end{bmatrix}.\]
Det andre bidraget forsvinner ikke. Men forholdet mellom bidragene er \(3^{-k}\), og derfor nærmer den normaliserte vektoren seg den første linjen. Vi kan se dette direkte ved å dele ut den dominerende skaleringen:
\[A^kx_0=\tfrac12 3^k\bigl(v_1+3^{-k}v_2\bigr),\qquad x_k=\frac{v_1+3^{-k}v_2}{\lVert v_1+3^{-k}v_2\rVert_2} \longrightarrow\frac{v_1}{\sqrt2}.\]
Prøv en annen startvektor: Hva endres i iterasjonsfølgen hvis startvektoren er \(x_0=v_2/\sqrt2\)? Da mangler bidraget langs \(v_1\) helt, slik du så med startvalget \((1,-1)\) i figuren.
Linearitet gir \(A(c_1v_1+c_2v_2)=c_1Av_1+c_2Av_2\). Sett inn \(Av_i=\lambda_iv_i\). Ved neste multiplikasjon får hvert bidrag enda en faktor \(\lambda_i\). Gjenta \(k\) ganger.
Samle basisvektorene i \(V=[v_1\ \cdots\ v_n]\) og egenverdiene i \(\Lambda=\operatorname{diag}(\lambda_1,\ldots,\lambda_n)\). Da betyr \(AV=V\Lambda\) at hver kolonne oppfyller egenvektorlikningen. Siden kolonnene er en basis, er \(V\) invertibel:
\[A=V\Lambda V^{-1},\qquad A^k=V\Lambda^kV^{-1}.\]
Les fra høyre: finn bidragene, skaler dem, og bygg vektoren igjen. Ikke alle matriser har en egenvektorbasis. Vi bruker en slik basis som forutsetning i denne forklaringen av potensmetoden.
Hvordan finner vi koeffisientene? For en vilkårlig startvektor \((a,b)^T\) løser vi
\[c_1(1,1)^T+c_2(1,-1)^T=(a,b)^T.\]
Koordinatene gir \(c_1+c_2=a\) og \(c_1-c_2=b\). Legg sammen og trekk fra:
\[c_1=\frac{a+b}{2},\qquad c_2=\frac{a-b}{2}.\]
For \((1,0)^T\) er begge \(1/2\). For \((1,-1)^T\) er \(c_1=0\). I matrisenotasjon er dette \(c=V^{-1}x_0\), hvor
\[V=\begin{bmatrix}1&1\\1&-1\end{bmatrix},\qquad V^{-1}=\frac12\begin{bmatrix}1&1\\1&-1\end{bmatrix}.\]
Videre er \(A^2=(V\Lambda V^{-1})(V\Lambda V^{-1})=V\Lambda^2V^{-1}\), fordi de to midterste faktorene gir \(V^{-1}V=I\). Slik får vi formelen for \(A^k\).
For to generelle egenverdier er forholdet mellom koeffisientenes absoluttverdier
\[\frac{|c_2\lambda_2^k|}{|c_1\lambda_1^k|} =\left|\frac{c_2}{c_1}\right|\left|\frac{\lambda_2}{\lambda_1}\right|^k.\]
Dette krever \(c_1\ne0\). Hvis \(\lambda_1<0\), skifter den dominerende koeffisienten fortegn i hvert steg; da konvergerer linjen, mens de normaliserte vektorene kan veksle mellom motsatte orienteringer.
Fra projeksjon i uke 4 til egenvektorbidrag
I uke 4.2 fant vi den ortogonale projeksjonen av en vektor \(x\) på en linje med enhetsvektor \(q\). Vi skilte mellom ett tall og en vektor:
\[\underbrace{c=q^Tx}_{\text{koordinaten langs }q},\qquad \underbrace{p=(q^Tx)q=cq}_{\text{projeksjonen på linjen gjennom }q}.\]
Nå bruker vi de samme projeksjonene på de to normaliserte egenretningene:
\[{\color{#1565c0}q_1=\frac1{\sqrt2}\begin{bmatrix}1\\1\end{bmatrix}}, \qquad {\color{#a04a00}q_2=\frac1{\sqrt2}\begin{bmatrix}1\\-1\end{bmatrix}}.\]
De har lengde én og står vinkelrett, så de danner en ortonormal basis for \(\mathbb R^2\). Dermed er enhver vektor summen av de to projeksjonene:
\[x={\color{#1565c0}(q_1^Tx)q_1} +{\color{#a04a00}(q_2^Tx)q_2}.\]
Hva er nytt i uke 5? Basisvektorene er også egenvektorer: \(Aq_1=3q_1\) og \(Aq_2=1q_2\). Under transformasjonen \(T(x)=Ax\) skaleres derfor hvert projeksjonsbidrag med sin egenverdi:
\[Ax={\color{#1565c0}3(q_1^Tx)q_1} +{\color{#a04a00}1(q_2^Tx)q_2}.\]
Figuren viser dette for \(x=(1,0)^T\). Til venstre er \(x\) summen av de to projeksjonene. Til høyre er det blå bidraget tredoblet og det oransje uendret, og summen er \(Ax=(2,1)^T\). Cellen regner ut koordinatene \(q_1^Tx\) og \(q_2^Tx\) og kontrollerer summen mot \(Ax\).
Diskuter: Hvis projeksjonen av startvektoren på linjen gjennom \(q_1\) er null, kan gjentatt anvendelse av \(T\) gi et bidrag langs denne linjen?
Spektralteoremet: en ortonormal basis av egenvektorer
Oppdelingen vi nettopp brukte, er mulig for alle reelle symmetriske matriser, ikke bare for eksemplet vårt. Spektralteoremet: En reell symmetrisk matrise \(A\) (\(A^T=A\)) har reelle egenverdier og en ortonormal basis av egenvektorer \(q_1,\ldots,q_n\) for hele \(\mathbb R^n\).
Sett egenvektorene som kolonner i \(Q=[q_1\ \cdots\ q_n]\) og de tilhørende egenverdiene på diagonalen i \(\Lambda\). Da er
\[A=Q\Lambda Q^T,\qquad Ax=\sum_{i=1}^n\lambda_i(q_i^Tx)q_i.\]
Faktoriseringen uttrykker akkurat oppdelingen vi nettopp brukte: \(Q^Tx\) gir koordinatene, \(\Lambda(Q^Tx)\) gir de skalerte koordinatene, og multiplikasjon med \(Q\) gir summen av de skalerte egenvektorbidragene.
Hvorfor står egenvektorene vinkelrett? Med \(A^T=A\) gir en regning på fire linjer \((\lambda-\mu)v^Tw=0\), så egenvektorer til ulike egenverdier er ortogonale (se fordypningen under). At det alltid finnes nok egenvektorer til en hel basis, tar vi som et kjent resultat.
En følge vi bruker i uke 6 og 9. Skriver vi \(x=\sum_ic_iq_i\) i egenvektorbasisen, er \(Ax=\sum_i\lambda_ic_iq_i\). Siden \(q_i^Tq_j\) er 1 når \(i=j\) og 0 ellers, blir \(x^TAx=\sum_i\lambda_ic_i^2\). Derfor er \(A\) positivt definitt, altså \(x^TAx>0\) for alle \(x\ne0\), akkurat når alle egenverdiene er positive. Og for alle \(x\) er \(x^TAx\ge\lambda_{\min}\lVert x\rVert_2^2\), der \(\lambda_{\min}\) er den minste egenverdien. Regningen står i fordypningen under, trinn 4.
Øv på dette: koordinater i en egenvektorbasis og gjentatt transformasjon i en egenvektorbasis.
Gå i dybden: fra projeksjonskoordinater til spektralteoremet
Vi følger ett eksempel hele veien: \(A=\begin{bmatrix}2&1\\1&2\end{bmatrix}\) og \(x=(1,0)^T\). Deretter undersøker vi hva symmetrien garanterer generelt.
I uke 4 kunne \(Q\) inneholde en basis for bare et underrom; da var \(QQ^Tx\) projeksjonen på dette underrommet. Her er basisen fullstendig, så \(QQ^Tx=x\) for alle \(x\) og \(QQ^T=I\).
1. Finn koordinatene med projeksjon fra uke 4
Normaliser egenvektorene \(v_1=(1,1)^T\) og \(v_2=(1,-1)^T\). Sett dem som kolonner i \(Q\), og beregn selv \(Q^TQ\) og \(c=Q^Tx\).
\[Q=\frac1{\sqrt2}\begin{bmatrix}1&1\\1&-1\end{bmatrix}, \qquad Q^TQ=I,\qquad c=Q^Tx=\frac1{\sqrt2}\begin{bmatrix}1\\1\end{bmatrix}.\]
Hver koordinat \(c_i=q_i^Tx\) er et tall. Projeksjonsvektoren er \(c_iq_i\). For denne \(x\) får vi
\[x={\color{#1565c0}\frac1{\sqrt2}q_1} +{\color{#a04a00}\frac1{\sqrt2}q_2} ={\color{#1565c0}\frac12v_1}+{\color{#a04a00}\frac12v_2}.\]
Koordinatene endres når basisvektorene normaliseres, men de to projeksjonsvektorene er uendret.
2. Skaler projeksjonsbidragene med egenverdiene
Siden \(Aq_1=3q_1\) og \(Aq_2=q_2\), blir
\[Ax={\color{#1565c0}\frac3{\sqrt2}q_1} +{\color{#a04a00}\frac1{\sqrt2}q_2} =\begin{bmatrix}2\\1\end{bmatrix}.\]
Dette er beregningen \(Ax=Q\Lambda(Q^Tx)\): finn koordinatene, skaler dem med egenverdiene, og summer de nye basisbidragene. Kontroller med direkte multiplikasjon at resultatet er det samme.
3. Hvorfor står egenretningene vinkelrett?
La nå \(A\) være en vilkårlig reell symmetrisk matrise, med \(Av=\lambda v\) og \(Aw=\mu w\). Da er
\[\begin{aligned} \lambda v^Tw&=(Av)^Tw &&\text{fordi }Av=\lambda v,\\ &=v^TA^Tw &&\text{ved transponering},\\ &=v^TAw &&\text{fordi }A^T=A,\\ &=\mu v^Tw &&\text{fordi }Aw=\mu w. \end{aligned}\]
Dermed er \((\lambda-\mu)v^Tw=0\). Ulike egenverdier gir derfor ortogonale egenvektorer når \(A\) er reell og symmetrisk.
Innenfor samme egenrom kan vi bruke Gram–Schmidt fra uke 4; alle lineærkombinasjonene forblir i egenrommet. Spektralteoremet sier i tillegg at det finnes nok egenvektorer til en basis for hele rommet. Dette siste utsagnet er ikke bevist av regningen ovenfor.
4. En følge vi bruker i uke 6 og 9
For en reell symmetrisk matrise skriver vi \(x=Qc\), der \(c=Q^Tx\). Da gir \(Q^TQ=I\) og \(A=Q\Lambda Q^T\) at
\[x^TAx=c^TQ^TQ\Lambda Q^TQc=c^T\Lambda c=\sum_i\lambda_i c_i^2.\]
Er alle egenverdiene positive, er summen positiv for enhver \(x\ne0\), fordi minst én koordinat \(c_i\) da er ulik null. Matrisen kalles da positivt definitt. Omvendt gir \(x=q_i\) at \(c=e_i\) og \(x^TAx=\lambda_i\), så positivt definitt krever at alle \(\lambda_i>0\). Dermed er en reell symmetrisk matrise positivt definitt akkurat når alle egenverdiene er positive.
Siden \(Q^TQ=I\), er \(\sum_ic_i^2=\lVert c\rVert_2^2=c^TQ^TQc=\lVert x\rVert_2^2\). Hvert ledd ligger mellom \(\lambda_{\min}c_i^2\) og \(\lambda_{\max}c_i^2\), så
\[\lambda_{\min}\lVert x\rVert_2^2\le x^TAx\le\lambda_{\max}\lVert x\rVert_2^2.\]
I uke 6 bruker vi egenskapen til å knytte løsningen av et lineært system til et entydig minimum, og i uke 9 til å vise at en kvadratisk funksjon vokser langt fra origo.
I denne fanen møter du eksperiment 3 om farten, potensmetoden med Rayleigh-kvotienten, og eksperiment 4. Tilfelle 2 og 3 i eksperiment 4 er fortegnsforsøket som prosjekt 5 viser til.
I eksperiment 2 vant bidraget med egenverdi 3 fordi det ble tredoblet i hvert steg, mens det andre bare ble ganget med 1. Men hva om de to egenverdiene ligger nær hverandre? Da vokser begge bidragene nesten like fort.
Vi beholder egenvektorene fra 5.3 og bytter bare ut den minste egenverdien, \(\mu\). Transformasjonen er \(A_\mu=Q\operatorname{diag}(3,\mu)Q^T\), der kolonnene i \(Q\) er de ortonormale egenvektorene \(q_1,q_2\). Vi sammenligner \(\mu=1\) og \(\mu=2.9\), begge fra startvektoren \(x_0=(1,0)^T\). Cellen regner ut de samme andelene \(a_1(k)\) og \(a_2(k)\) som i eksperiment 2. Blå er \(a_1\), oransje er \(a_2\); heltrukket er \(\mu=1\) og stiplet er \(\mu=2.9\). Målet er å se hva som bestemmer farten når én retning tar over.
Eksperiment 3 – hva bestemmer farten?
- Forutsi hvilket kurvepar som raskest nærmer seg andelene 1 og 0.
- Kjør cellen og sammenlign de to oransje kurvene etter 10 steg.
- Omtrent hvor mange steg trengs før hver oransje kurve kommer under 0.1?
Hva viser forsøket? For \(\mu=1\) er den oransje andelen nesten borte etter 10 steg, mens den for \(\mu=2.9\) fortsatt er over 0.4. Når \(\mu\) ligger nær 3, vokser begge bidragene nesten like mye ved hvert steg, og det tar lang tid før det ene tar over. Det er forholdet mellom egenverdiene, \(\mu/3\), som bestemmer farten.
Gå i dybden: knytt andelskurvene til egenverdiene
Startvektoren har like store koordinater langs \(q_1\) og \(q_2\). Etter \(k\) multiplikasjoner er forholdet mellom bidragenes lengder derfor
\[R_k=\frac{\lVert b_2(k)\rVert_2}{\lVert b_1(k)\rVert_2} =\left(\frac{|\mu|}{3}\right)^k.\]
Forholdet \(R_k\) og andelen \(a_2(k)\) er ulike størrelser. Del teller og nevner i andelsformelen på \(\lVert b_1(k)\rVert_2\):
\[{\color{#1565c0}a_1(k)=\frac{1}{1+R_k}},\qquad {\color{#a04a00}a_2(k)=\frac{R_k}{1+R_k}}.\]
Ved \(k=0\) er begge andelene \(1/2\). Etter 10 steg er den oransje andelen omtrent \(0.0000169\) for \(\mu=1\), men \(0.416\) for \(\mu=2.9\).
For å få \(a_2(k)<0.1\) må
\[\frac{R_k}{1+R_k}<0.1\quad\Longleftrightarrow\quad R_k<\frac19.\]
Dette gir 3 steg for \(\mu=1\) og 65 steg for \(\mu=2.9\). For \(\mu=1\) er andelen nøyaktig 0.1 ved \(k=2\), så kurven berører grensen allerede der. Kontroller med potensuttrykket for \(R_k\).
Dette minner om konvergensfarten i uke 2.2–2.3: der ble en liten feil omtrent ganget med \(|g'(r)|\) ved hvert steg. Her gjelder den eksakte skaleringen \(R_{k+1}=(|\mu|/3)R_k\) for forholdet mellom bidragene. En faktor nær én gir langsom endring i begge tilfeller.
I koden beregner vi koordinatene fra de itererte vektorene, ikke direkte fra potensformelen. Avrunding kan derfor påvirke svært små bidrag. Den lineære andelsaksen gjør sammenligningen med eksperiment 2 direkte, men viser ikke slike små avvik tydelig.
Skriv opp det vi nettopp gjorde
Vi samler stegene fra forsøkene i én algoritme. Dette er potensmetoden:
Velg x ≠ 0 og del x på lengden sin.
Gjenta, med en øvre grense for antall steg:
    y = A x
    Hvis y = 0: stopp; normalisering er ikke mulig.
    x = y / ‖y‖₂
    Finn et tall ρ som beskriver skaleringen langs x.
    Kontroller hvor godt A x ≈ ρ x.
Ett steg består av multiplikasjon og normalisering:
\[y_k=Ax_k,\qquad x_{k+1}=\frac{y_k}{\lVert y_k\rVert_2}.\]
Potensmetoden som fikspunktiterasjon
I uke 2.1 brukte vi \(x_{k+1}=g(x_k)\) for å nærme oss et tall \(r\) med \(g(r)=r\). Oppdateringen \(x_{k+1}=F(x_k)\) med \(F(x)=Ax/\lVert Ax\rVert_2\) fra 5.1 har samme form, bare for vektorer: potensmetoden er en fikspunktiterasjon. Et fikspunkt \(F(x_*)=x_*\) betyr
\[Ax_*=\lVert Ax_*\rVert_2\,x_*,\]
altså at \(x_*\) er en enhetsegenvektor med positiv egenverdi. Egenverdiene og bidragene i startvektoren avgjør om følgen nærmer seg et fikspunkt.
Fra projeksjon til et anslag for egenverdien
Potensmetoden finner først en mulig egenvektorretning \(x\). Vi trenger også en skalering: hvilket tall \(t\) gjør \(tx\) til den beste tilnærmingen til \(Ax\)? Vi søker altså den ortogonale projeksjonen av \(Ax\) på linjen \(\operatorname{span}\{x\}\), ikke på en av koordinataksene.
Fra uke 4 er projeksjonen av en vektor \(b\) på linjen gjennom \(x\ne0\) lik \(\frac{x^Tb}{x^Tx}x\). Med \(b=Ax\) blir projeksjonen \(\rho(x)x\), der
\[\rho(x)=\frac{x^TAx}{x^Tx},\qquad r=Ax-\rho(x)x,\qquad x^Tr=0.\]
\(\rho\) kalles Rayleigh-kvotienten og er koeffisienten som minimerer \(\|Ax-tx\|_2\) over alle tall \(t\). Egenresidualen \(r\) er den delen av \(Ax\) som står vinkelrett på \(x\) og derfor ikke kan beskrives som en skalering av \(x\).
Utgangspunkt. \(A=\begin{bmatrix}2&1\\1&2\end{bmatrix}\). Vi sammenligner startvektoren \(x_0=(1,0)^T\) med første normaliserte steg \(x_1=(2,1)^T/\sqrt5\) fra 5.1.
Prøv selv. Regn ut \(Ax_0\), \(\rho(x_0)\) og \(r_0\) før du leser videre.
Regnegangen. Begge vektorene har lengde én, så \(\rho=x^TAx\).
- \(x_0\): \(Ax_0=(2,1)^T\) og \(\rho=x_0^TAx_0=1\cdot2+0\cdot1=2\). Resten er \(r_0=(2,1)^T-2(1,0)^T=(0,1)^T\), med \(\lVert r_0\rVert_2=1\).
- \(x_1\): \(Ax_1=\dfrac1{\sqrt5}\begin{bmatrix}2\cdot2+1\\2+2\cdot1\end{bmatrix}=\dfrac{(5,4)^T}{\sqrt5}\) og \(\rho=x_1^TAx_1=\dfrac{2\cdot5+1\cdot4}{5}=\dfrac{14}{5}\). Resten er \[r_1=Ax_1-\tfrac{14}{5}x_1=\frac1{5\sqrt5}\Bigl(\begin{bmatrix}25\\20\end{bmatrix}-\begin{bmatrix}28\\14\end{bmatrix}\Bigr) =\frac1{5\sqrt5}\begin{bmatrix}-3\\6\end{bmatrix},\] med \(\lVert r_1\rVert_2=\dfrac{\sqrt{9+36}}{5\sqrt5}=\dfrac{\sqrt{45}}{5\sqrt5}=\dfrac35\).
- Kontroll: \(x_1^Tr_1=\tfrac1{25}\bigl(2\cdot(-3)+1\cdot6\bigr)=0\). Resten står vinkelrett på \(x_1\).
Dette tar vi med oss. Etter ett steg er \(\rho\) nærmere egenverdien 3 (fra 2 til 2.8), og resten har krympet fra 1 til 3/5. For \(x=(1,1)^T/\sqrt2\) er \(\rho=3\) og \(r=0\): da er \(x\) en egenvektor.
Figuren viser projeksjonen av \(Ax\) på linjen gjennom \(x\): den grønne pilen er \(\rho x\), og den stiplede er resten \(r\), som står vinkelrett på \(x\). Cellen regner ut \(\rho\) og \(r\) for \(x_0\) fra håndeksempelet.
Hva forteller kontrollen? Liten \(\|r\|_2\) betyr at egenvektorlikningen nesten er oppfylt. Det sier ikke at vi har funnet den dominante egenverdien: retningen med egenverdi 1 gir også null residual. Derfor ser vi både på startvektoren, utviklingen i forsøket og residualen når vi vurderer resultatet.
Gå i dybden: hvorfor akkurat denne kvotienten?
Vi prøver å beskrive \(Ax\) ved én vektor \(\rho x\) på linjen gjennom \(x\). Projeksjonskoeffisienten minimerer \(\lVert Ax-tx\rVert_2\) over tall \(t\). Vi kan også finne den ved ortogonalitetskravet fra uke 4:
\[x^T(Ax-\rho x)=0 \quad\Longrightarrow\quad x^TAx-\rho x^Tx=0 \quad\Longrightarrow\quad \rho=\frac{x^TAx}{x^Tx}.\]
For en enhetsvektor blir dette \(\rho=x^TAx\). For en generell matrise gir en liten residual heller ikke alene en garanti for at vektoren ligger nær en bestemt eksakt egenvektor.
Fikspunkt. Normaliseringen gjør \(F\) til en ikke-lineær avbildning, selv om \(x\mapsto Ax\) er lineær. I 5.4 så vi at et fikspunkt er en enhetsegenvektor med positiv egenverdi. Omvendt er enhver enhetsegenvektor med positiv egenverdi \(\lambda\) et fikspunkt, fordi \(F(v)=\lambda v/\lambda=v\).
Fikspunktresidual og egenresidual er ulike. I uke 2.4 målte vi fikspunktresidualen \(g(x)-x\). Her måler vi egenresidualen \(Ax-\rho x\), som kontrollerer en annen likning. For en enhetsegenvektor \(v\) med negativ egenverdi er \(F(v)=-v\) og \(F(-v)=v\). Iterasjonen veksler da mellom to vektorer på samme linje: linjen er uendret, men vektoren er ikke et fikspunkt. Egenresidualen er null, mens fikspunktresidualen er \(F(v)-v=-2v\). Derfor kan potensmetoden ha funnet en egenvektor selv om neste normaliserte vektor har motsatt fortegn. Dette ser vi i eksperiment 4.
En residual er en vektor; residualnormen er ett tall. I koden lagrer vi både \(\rho\) og residualnormen, ikke hele residualvektoren.
Gå i dybden: implementasjonen av potensmetoden
Cellen med definisjonen kjøres automatisk. Les koden side om side med pseudokoden: normalisering, Rayleigh-kvotient, residual og en øvre grense for antall steg.
Følg én løkkeomgang: y er \(Ax\), rho er \(x^TAx\) siden \(\lVert x\rVert_2=1\), og residual er \(\lVert Ax-\rho x\rVert_2\). Vi lagrer kontrollene før neste oppdatering. Derfor gjelder siste rad i history akkurat den vektoren funksjonen returnerer.
scale er \(\lVert A\rVert_F\), Frobeniusnormen: kvadratroten av summen av alle kvadrerte matriseelementer. Toleransen tol angir hvor liten relativ residual vi krever: stoppkravet er \(\lVert r\rVert_2/\lVert A\rVert_F\le\text{tol}\) for \(A\ne0\). En felles skalering av \(A\) skalerer både teller og nevner like mye. max_steps hindrer at et ikke-konvergerende forsøk fortsetter uten grense.
Hvis \(Ax=0\), er \(x\) allerede en egenvektor for null, men vi kan ikke utføre neste normalisering. Meldingen forklarer dette særtilfellet.
Nå prøver vi potensmetoden på matrisen fra 5.1, med startvektoren \((1,0)^T\). Funksjonen power_iteration er skrevet ferdig i fordypningen over og er allerede lastet inn. Den gjør nøyaktig stegene i pseudokoden og stopper når egenresidualen er liten. Kjør cellen og sammenlign \(\rho\) med egenverdien 3 fra 5.2.
Potensmetoden virket fint i eksperiment 3 og her. Men den bygger på to forutsetninger: én egenverdi er størst i absoluttverdi, og startvektoren har et bidrag langs den tilhørende egenvektoren. Nå bryter vi forutsetningene én om gangen, med enkle matriser der vi kan regne alt for hånd. I alle fire tilfellene bruker vi samme oppdatering \(x_{k+1}=Ax_k/\lVert Ax_k\rVert_2\). Målet er å se at «retningen stabiliseres», «vi har funnet en egenvektor» og «vi har funnet den største egenverdien» er tre forskjellige påstander.
Eksperiment 4 – når stabiliseres ikke retningen?
| Tilfelle | Matrise for transformasjonen | Startvektor før normalisering | Spørsmål før kjøring |
|---|---|---|---|
| Manglende dominant bidrag | \(\operatorname{diag}(3,1)\) | \((0,1)^T\) | Kan første koordinat bli ulik null? |
| Negativ dominant egenverdi | \(\operatorname{diag}(-3,1)\) | \((1,1)^T\) | Hva skjer med fortegnet til første koordinat ved hvert steg? |
| Like store absoluttverdier | \(\operatorname{diag}(1,-1)\) | \((1,1)^T\) | Kan ett av de to bidragene dominere det andre? |
| Rotasjon | \(\begin{bmatrix}0&-1\\1&0\end{bmatrix}\) | \((1,0)^T\) | Hva skjer når en kvart omdreining gjentas? |
- Forutsi: hvilket tilfelle gir samme vektor ved hvert steg?
- Hvilket nærmer seg én linje uten å nærme seg én bestemt enhetsvektor?
- Hvilke gir en gjentakende syklus? Kjør og sammenlign.
Hvert punkt i figuren er endepunktet til en normalisert vektor \(x_k\), for \(k=0,\ldots,6\); strekene forbinder påfølgende punkter, og like punkter ligger oppå hverandre. Utskriften kommer fra en egen kjøring av power_iteration med inntil 100 steg, så den kan rapportere et annet antall steg enn de seks som tegnes.
Hva viser forsøket? Hvert tilfelle bryter en annen forutsetning.
1. Manglende dominant bidrag: riktig egenvektor, men feil egenverdi for målet vårt. Fra \(x_0=(0,1)^T\) er \(Ax_0=x_0\). Første koordinat forblir null, så iterasjonen kan ikke utvikle et bidrag langs egenvektoren til egenverdi 3. Den returnerer egenverdi 1 med residual null. Kontrollen bekrefter et egenpar, men bekrefter ikke at egenverdien er størst i absoluttverdi.
2. Negativ dominant egenverdi: linjen stabiliseres, orienteringen veksler. Før normalisering er \(A^k(1,1)^T=((-3)^k,1)^T\). Første koordinat dominerer og skifter fortegn, så vektorene nærmer seg vekselvis \((1,0)^T\) og \((-1,0)^T\) på samme egenlinje. \(\rho\) nærmer seg \(-3\) og residualen null, selv om vektorene ikke konvergerer mot ett punkt.
3. Like store absoluttverdier: ingen av bidragene blir dominerende. Vektorene veksler mellom \((1,1)^T/\sqrt2\) og \((1,-1)^T/\sqrt2\): to forskjellige linjer. Bidragene beholder lengden; bare fortegnet til det andre endres. \(\rho=0\) og residualen er 1 (utskriften kan vise et tall som 4e-17 for \(\rho\); det er 0 pluss avrunding).
Tilfelle 2 og 3 kaller vi fortegnsforsøket: en negativ egenverdi får bidraget til å skifte fortegn ved hvert steg. I tilfelle 3 er størrelsen \(|-1|=1\), så vekslingen fortsetter for alltid. Hva som skjer når den negative egenverdien har absoluttverdi mindre enn én, ser du i fordypningen om pendling i 5.6 og i prosjekt 5.
4. Rotasjon: ingen reell egenlinje å nærme seg. Hver multiplikasjon dreier vektoren \(90^\circ\), så iterasjonen besøker fire punkter og starter på nytt. Ingen reell ikke-null vektor oppfyller \(Ax=\lambda x\).
Diskuter: Hvorfor er det tre forskjellige spørsmål om vektorene konvergerer, om linjen de spenner ut stabiliseres, og om vi har funnet egenverdien med størst absoluttverdi? Bruk tilfelle 1 og 2 som eksempler.
Øv på dette: ett steg av potensmetoden for hånd, og programmer potensmetoden.
Gå i dybden: beregn forløpene og skill mellom vektor og linje
Beregn to steg i hvert tilfelle. Normaliser startvektoren først. Beregn deretter Rayleigh-kvotienten \(\rho_k=x_k^TAx_k\) og egenresidualen \(r_k=Ax_k-\rho_kx_k\). Sammenhold med observasjonene ovenfor.
For de tre diagonalmatrisene kan vi først regne uten normalisering:
\[\begin{aligned} \operatorname{diag}(3,1)^k(0,1)^T&=(0,1)^T,\\ \operatorname{diag}(-3,1)^k(1,1)^T&=((-3)^k,1)^T,\\ \operatorname{diag}(1,-1)^k(1,1)^T&=(1,(-1)^k)^T. \end{aligned}\]
I andre tilfelle deler vi på \(\sqrt{3^{2k}+1}\). Andre koordinat går da mot null, mens første går mot 1 ved partallsstegene og mot \(-1\) ved oddetallsstegene. I tredje tilfelle deler vi alltid på \(\sqrt2\), så begge bidragene består.
Hvordan måle endring av linje? Enhetsvektorene \(x\) og \(-x\) spenner ut samme linje. Derfor kan vi sammenligne begge orienteringene:
\[d_k=\min\bigl(\lVert x_{k+1}-x_k\rVert_2, \lVert x_{k+1}+x_k\rVert_2\bigr).\]
Første norm er liten når vektorene er nesten like; andre norm er liten når de er nesten motsatte. I tilfelle 2 går \(d_k\) mot null, selv om \(\lVert x_{k+1}-x_k\rVert_2\) går mot 2. I tilfelle 3 og 4 er påfølgende vektorer ortogonale, så \(d_k=\sqrt2\). En liten \(d_k\) alene sier likevel ikke hvilken egenverdi vi har funnet.
Rotasjonen. Den gir \((1,0)^T\mapsto(0,1)^T\mapsto(-1,0)^T\mapsto(0,-1)^T\) og deretter startvektoren igjen. For enhver reell enhetsvektor står \(Ax\) vinkelrett på \(x\), så \(\rho=x^TAx=0\) og \(\lVert Ax-\rho x\rVert_2=1\). Determinantlikningen er \(\lambda^2+1=0\), som ikke har reelle løsninger. Over komplekse tall er egenverdiene \(i\) og \(-i\).
Sykluser. I uke 2.3 så vi at en iterasjon kan nærme seg en 2-syklus i stedet for et fikspunkt. Tilfelle 2 og 3 viser samme skille for vektorer: to tilstander gjentas eller nærmes vekselvis, selv om ett enkelt grensepunkt mangler.
Tilfelle 1 beskriver eksakt regning. Avrunding kan i andre beregninger tilføre et lite bidrag som er null i eksakt regning. Her brukes en diagonalmatrise og en eksakt nullkoordinat for å isolere mekanismen. Den neste fordypningen undersøker hva som skjer når startvektoren får et lite bidrag langs den dominante egenretningen.
Gå i dybden: kan en liten startforskjell vokse?
I tilfelle 1 i eksperiment 4 ble iterasjonsfølgen værende langs \((0,1)^T\), selv om egenverdien \(3\) tilhører retningen \((1,0)^T\). Startvektoren hadde nøyaktig null bidrag i denne retningen. Hvor følsom er denne konklusjonen for en liten endring i startvektoren? Dette er relevant når startdata ikke er helt nøyaktige. Målet er å se om en nesten manglende retning oppfører seg som en helt manglende.
Vi bruker fortsatt \(A=\operatorname{diag}(3,1)\) og sammenligner startvektorene \((0,1)^T\) og \((10^{-12},1)^T\), begge normalisert til lengde én. Cellen gjør 30 steg med multiplikasjon og normalisering og skriver ut de to vektorene. Vil de fortsatt være nesten like? Prøv deretter 10 og 20 steg: når blir forskjellen tydelig?
Koble observasjonen til egenverdiene: Ved hver multiplikasjon blir det første bidraget skalert med \(3\), mens det andre blir skalert med \(1\). Normaliseringen deler begge koordinatene på samme tall og endrer derfor ikke forholdet mellom dem. For startvektoren \((\varepsilon,1)^T\) får vi
\[\frac{|(x_k)_1|}{|(x_k)_2|}=3^k|\varepsilon|.\]
For \(\varepsilon=10^{-12}\) og \(k=30\) er forholdet \(3^{30}10^{-12}\approx206\). Den opprinnelig lille delen dominerer. Et bidrag som er nøyaktig null, forblir null i dette eksemplet. Et lite bidrag som ikke er null, kan etter tilstrekkelig mange steg dominere.
Startfeil og feil i hvert steg. Her er \(10^{-12}\) en bevisst innlagt forstyrrelse av startdata. For en unormalisert beregning med lokal avrundingsfeil \(\delta_k\) i steg \(k\), skriv \(\widehat y_{k+1}=A\widehat y_k+\delta_k\). Feilen mot eksakt regning oppfyller da \(e_{k+1}=Ae_k+\delta_k\). Etter \(k\) steg blir den
\[e_k=A^ke_0+\sum_{j=0}^{k-1}A^{k-1-j}\delta_j.\]
Hver lokal feil virker videre gjennom de neste multiplikasjonene. Stor absoluttverdi av en egenverdi kan forsterke et feilbidrag i egenretningen. Formelen gjelder den unormaliserte beregningen; normalisering endrer feillikningen, men fjerner ikke mekanismen med relativ vekst mellom retningene.
Fra lenker til en rangering
Hvordan kan lenkene fortelle oss hvilke nettsider som er viktige? Vi vil gi hver side et tall og rangere sidene fra høyest til lavest verdi. En lenke kan tolkes som en anbefaling, men en lenke fra en side mange besøker, bør telle mer enn en lenke fra en side få besøker.
PageRank bygger på denne ideen. Vi lar en tenkt besøkende følge lenkene fra side til side. En side regnes som viktig hvis den besøkende ofte havner der.
Vi begynner med de fire nettsidene A–D i figuren. En pil A → B betyr at A har en lenke til B. Den besøkende velger én av lenkene på siden hen er på, med lik sannsynlighet, og åpner siden lenken peker til. Dette lenkeklikket er ett steg i besøksmodellen.
Fra A er det to valg: B og C, hver med sannsynlighet \(1/2\). Fra B er C det eneste valget. Tallene på pilene er overgangssannsynligheter: sannsynligheten for neste side, gitt siden den besøkende er på nå. Punktenes plassering i tegningen påvirker ikke regelen.
En slik tilfeldig følge av besøk, for eksempel A → B → C → D → A, kalles en tilfeldig vandring (random walk).
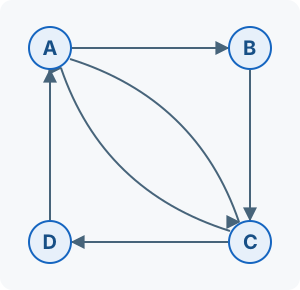
En tilfeldig vandring gir én side ved hvert steg. For å undersøke hvilke sider besøksregelen favoriserer, følger vi i stedet sannsynlighetsfordelingen: fire tall som angir sannsynligheten for å være på A, B, C og D etter et bestemt antall steg. Tallene summerer til 100 %. De beskriver dette tidspunktet, ikke antall besøk samlet over tid.
Figuren regner ut fordelingen direkte; den trekker ikke en enkelt besøkendes rute. 100 % på A betyr sikker start på A, og 25 % på hver side betyr tilfeldig startside. Beregn ett steg oppdaterer fordelingen for ett lenkeklikk. Målet er å se om startsiden betyr noe for rangeringen når den besøkende har klikket seg rundt lenge.
Eksperiment 5 – gir ulike startfordelinger samme rangering?
- Velg 100 % på A. Forutsi med pilene hvilke sider som er mulige etter ett steg, og trykk Beregn ett steg to ganger.
- Start på nytt med 100 % på A og trykk Beregn 20 steg. Hvilke sider ser ut til å få høyest rang?
- Gjenta fra 25 % på hver side. Påvirker startvalget rangeringen etter mange steg?
Hva viser forsøket? Etter 20 steg er fordelingen nesten den samme fra begge startene: A og C har omtrent 33.3 %, B og D omtrent 16.7 %. Startvalget ser ikke ut til å påvirke rangeringen etter mange steg. Nå forklarer vi hvorfor, med en matrise.
Fra besøksregelen til et matriseprodukt
Vi samler sannsynlighetene i en kolonnevektor, i rekkefølgen A, B, C, D:
\[p_k=(p_A^{(k)},p_B^{(k)},p_C^{(k)},p_D^{(k)})^T.\]
Her teller \(k\) stegene i modellen. For eksempel er \(p_0=(1,0,0,0)^T\) når startsiden sikkert er A. En vektor med ikke-negative elementer og sum én kalles en sannsynlighetsvektor.
Besøksregelen lagres i en overgangsmatrise \(S\). Elementet \(S_{ij}\) er sannsynligheten for å gå fra side \(j\) til side \(i\): kolonnen er siden vi går fra, og raden er siden vi går til. Kolonne A blir derfor \((0,1/2,1/2,0)^T\).
\[S=\begin{array}{c|rrrr} & A&B&C&D\\\hline A&0&0&1/2&1\\ B&1/2&0&0&0\\ C&1/2&1&0&0\\ D&0&0&1/2&0 \end{array},\qquad p_{k+1}=Sp_k.\]
Matriseproduktet vekter hver kolonne med sannsynligheten for å være på avsendersiden og summerer bidragene til hver mottaker. For eksempel mottar A halvparten av bidraget fra C og hele bidraget fra D. Bidraget fra en side er proporsjonalt med sannsynligheten for å være der, og deles likt mellom sidens utgående lenker.
Tenk på 1000 besøkende som følger regelen samtidig. Er 400 av dem på C, går halvparten, altså 200, videre til A og 200 til D. Sannsynlighetene i \(p\) kan leses som slike andeler, og \(Sp\) regner ut de nye andelene.
Alle kolonnene har ikke-negative elementer og sum én. En slik matrise kalles kolonnestokastisk. Oppdateringen \(p\mapsto Sp\) bevarer summen i \(p\).
Hvorfor bevares summen? La \(\mathbf1=(1,1,1,1)^T\). Summen av elementene i \(p\) er \(\mathbf1^Tp\), og kolonnesum én betyr \(\mathbf1^TS=\mathbf1^T\). Da er \(\mathbf1^T(Sp)=(\mathbf1^TS)p=\mathbf1^Tp=1\). Siden \(S\) og \(p\) har ikke-negative elementer, har også \(Sp\) det. Gjentar vi oppdateringen, får vi \(p_k=S^kp_0\): samme gjentatte matrisemultiplikasjon som tidligere i uken, nå uten normalisering av lengden.
Når fordelingen ikke lenger endres
I forsøket nærmet de to startfordelingene seg samme fordeling. En fordeling som er uendret ved neste steg, kalles stasjonær. Dette er et fikspunkt, slik som i uke 2.1, nå for oppdateringen \(p\mapsto Sp\). Vi markerer den med en stjerne:
\[Sp_*=p_*=1p_*.\]
Her møter vi egenvektorene igjen: \(p_*\) er en egenvektor med egenverdi 1, skalert til sum én. Iterasjonen \(p_{k+1}=Sp_k\) er dermed både en fikspunktiterasjon og en variant av potensmetoden fra 5.4. Her bevares summen én av besøksregelen, så vi trenger ingen ekstra normalisering. Men vi kan også finne \(p_*\) direkte, uten å iterere.
Utgangspunkt. Vi leter etter en sannsynlighetsvektor \(p=(p_A,p_B,p_C,p_D)^T\) med \(Sp=p\).
Prøv selv. Skriv opp én likning per rad i \(S\). Hvilken likning er enklest å starte med?
Regnegangen. Radene i \(S\) gir
\[p_A=\tfrac12p_C+p_D,\quad p_B=\tfrac12p_A,\quad p_C=\tfrac12p_A+p_B,\quad p_D=\tfrac12p_C.\]
- Andre likning: \(p_B=\tfrac12p_A\).
- Sett inn i tredje: \(p_C=\tfrac12p_A+\tfrac12p_A=p_A\).
- Fjerde: \(p_D=\tfrac12p_C=\tfrac12p_A\).
- Første likning stemmer nå av seg selv: \(\tfrac12p_A+\tfrac12p_A=p_A\).
Alle løsninger er \(t(1,\tfrac12,1,\tfrac12)^T\). Summen er \(3t\), så kravet «sum én» gir \(t=\tfrac13\) og
\[p_*=(1/3,\,1/6,\,1/3,\,1/6)^T.\]
Dette tar vi med oss. \(Sp=p\) bestemmer en egenretning med egenverdi 1. Kravet «sum én» velger den ene vektoren på linjen som er en sannsynlighetsfordeling. I prosjekt 5 bygger du \(S\) for seks sider på samme måte.
Rangerer vi etter disse sannsynlighetene, deler A og C førsteplassen, mens B og D deler neste plass. Den besøkende fortsetter å følge lenker; det er sannsynlighetene som er uendret.
Dette er et mål på viktighet under besøksregelen; modellen kjenner ikke innholdet. Og likningen \(Sp_*=p_*\) alene sier ikke at alle startfordelinger nærmer seg \(p_*\). Det undersøker vi i 5.6.
Øv på dette: stasjonære fordelinger for to og tre sider.
Gå i dybden: fra lenkeklikk til matriseprodukt
Én besøkende er på én side om gangen. Etter ett steg fra A er sannsynligheten \(1/2\) for B og \(1/2\) for C. Starter mange uavhengige besøkende på A, er dette også de forventede andelene på B og C. De faktiske andelene i et tilfeldig forsøk kan avvike.
De to første oppdateringene fra A gir
\[\underbrace{\begin{bmatrix}1\\0\\0\\0\end{bmatrix}}_{p_0} \longmapsto\underbrace{\begin{bmatrix}0\\1/2\\1/2\\0\end{bmatrix}}_{p_1} \longmapsto\underbrace{\begin{bmatrix}1/4\\0\\1/2\\1/4\end{bmatrix}}_{p_2}.\]
Ved det andre steget går hele B-bidraget på \(1/2\) til C. C-bidraget på \(1/2\) deles i to: \(1/4\) til A og \(1/4\) til D.
Generelt er \(S_{ij}\) sannsynligheten for å gå til \(i\) når vi er på \(j\). Produktet \(S_{ij}p_j\) er derfor sannsynligheten for både å være på \(j\) nå og gå videre til \(i\). Siden avsendersidene utelukker hverandre, summerer vi bidragene:
\[(Sp)_i=\sum_j S_{ij}p_j.\]
Dette er rad-ganger-kolonne-regelen. Vi kan også lese produktet kolonnevis: \(Sp\) er summen av kolonnene i \(S\), vektet med koordinatene i \(p\). Kolonne \(j\) er \(Se_j\), der \(e_j\) er standardbasisvektoren som betyr sikker start på side \(j\). Slik kjenner vi igjen matriserepresentasjonen av en lineær transformasjon fra tidligere uker.
Prøv for hånd: Start med \(p=(1/4,1/4,1/4,1/4)^T\). Til A kommer \(\tfrac12\cdot\tfrac14+1\cdot\tfrac14=3/8\). Kontroller de andre radene og få \(Sp=(3/8,1/8,3/8,1/8)^T\).
Oppdateringen sender altså sannsynlighetsvektorer til sannsynlighetsvektorer, som vi viste over. Vi trenger ikke dele på vektorlengden. Merk forskjellen på kolonne- og radsummer: \(\mathbf1^TS=\mathbf1^T\) betyr ikke \(S\mathbf1=\mathbf1\). Rad A summerer til \(3/2\), fordi den samler bidrag fra forskjellige avsendere.
Gå i dybden: hvorfor har S egenverdi 1, og en kontroll med kode
Kolonnesummene viser dessuten at \(S^T\mathbf1=\mathbf1\). Dermed har \(S^T\) egenverdi én. En matrise og dens transponerte har samme karakteristiske polynom \(\det(S-\lambda I)\), så også \(S\) har egenverdi én. Dette argumentet alene sier ikke at \(S^kp_0\) konvergerer.
Kontroller med kode: Kjør cellen fra begge startfordelingene. Sammenlign resultatet med den eksakte løsningen \(p_*=(1/3,1/6,1/3,1/6)^T\). Utskriften måler største koordinatendring ved neste steg. Hvorfor kan et lite tall bekrefte at fordelingen er nesten stasjonær uten å bekrefte at vi la inn riktige lenker?
I 5.5 ga lenkene en fornuftig rangering, og begge startfordelingene vi prøvde, endte likt. Men lenkene på ekte nettsider er ikke alltid så snille. Kan en side få høyest verdi bare fordi besøkende ikke kommer seg videre? Vi beholder nettverket fra 5.5, men endrer bare lenken fra D: D → A blir D → D, så den eneste lenken på D fører tilbake til D selv. Det endrer bare én kolonne i \(S\). Cellen kjører den samme oppdateringen \(p_{k+1}=Sp_k\) som før, fra 25 % på hver side, og tegner sannsynligheten for hver side mot antall steg. Målet er å se at en fordeling kan være stasjonær og likevel gi en rangering vi ikke vil ha.
Eksperiment 6 – kan én side fange besøkene?
- Gjett først: D har fortsatt bare én innkommende lenke fra en annen side. Hvordan utvikler sannsynligheten for D seg?
- Kjør cellen. Hvilke veier fører til D, og hvilke fører ut igjen?
- Hva blir rangeringen etter mange steg?
Hva viser forsøket? D er blitt en felle: den besøkende kan komme dit, men lenkene gir ingen utvei. Fordelingen nærmer seg \((0,0,0,1)^T\), slik at D får all vekt i rangeringen. D kommer øverst fordi siden holder på besøkene, ikke fordi mange anbefaler den.
Regningen konvergerer altså til en stasjonær fordeling, men besøksregelen gir et lite nyttig mål på viktighet. En liten residual \(Sp-p\) viser at \(p\) omtrent oppfyller modellens likning; den kan ikke bekrefte at modellen måler det vi ønsker.
Gå i dybden: en korrekt løsning for en uheldig besøksregel
Kall den endrede overgangsmatrisen \(S_{\mathrm{felle}}\). Endringen D → A til D → D bytter siste kolonne fra \((1,0,0,0)^T\) til \((0,0,0,1)^T\). Den nye D-raden gir
\[p_D^{(k+1)}=\tfrac12p_C^{(k)}+p_D^{(k)}\geq p_D^{(k)}.\]
Sannsynligheten som er på D, blir værende der, mens C kan sende mer inn. For \(p=(0,0,0,1)^T\) får vi nøyaktig
\[S_{\mathrm{felle}}p=p,\qquad r=S_{\mathrm{felle}}p-p=0.\]
En null residual bekrefter stasjonaritet. At D får all vekt, følger av lenkene vi valgte. En selvlenke er altså noe annet enn mangel på lenker: her finnes et lenkevalg, men det gir ingen utvei.
Vi gir den besøkende en ny mulighet. Ved hvert steg velger hen mellom to handlinger:
- Med sannsynlighet \(\alpha\) følger hen en lenke etter regelen vi allerede har.
- Med sannsynlighet \(1-\alpha\) velger hen neste side uavhengig av lenkene, med lik sannsynlighet blant A–D. Også nåværende side kan velges.
Det siste kalles teleportering. Ett steg i denne modellen kan altså være et lenkeklikk eller et tilfeldig hopp. Dempingsfaktoren \(\alpha\) bestemmer hvor stor vekt lenkene får. Når \(\alpha=0.85\), er sannsynligheten 85 % for et lenkeklikk og 15 % for et hopp. Hoppfordelingen \(u=(1/4,1/4,1/4,1/4)^T\) beskriver hvor hoppet lander. Cellen bruker fellen fra eksperiment 6 og gjør 500 steg med regelen \(p\mapsto\alpha\,(\text{lenkesteg})+(1-\alpha)u\) for tre verdier av \(\alpha\). Målet er å se om hoppene gir alle sidene en positiv verdi, og hvor mye valget av \(\alpha\) betyr.
Eksperiment 7 – hva endres når vi kan hoppe ut?
- Gjett først: hvordan endres verdien til D når vi gjør hopp vanligere?
- Kjør cellen og sammenlign \(\alpha=0.95\), \(0.85\) og \(0.5\).
- Hvor stor vekt beholder D, og får de andre sidene positiv sannsynlighet?
Hva viser forsøket? D beholder fortsatt mest vekt, men nå får alle sidene positiv sannsynlighet. Jo vanligere hopp, desto mindre vekt på D: omtrent 0.38 ved \(\alpha=0.5\), 0.67 ved \(\alpha=0.85\) og 0.86 ved \(\alpha=0.95\). Rekkefølgen D, C, A, B er den samme for alle tre verdiene her, men på andre nettverk kan også rekkefølgen endres: å endre sannsynligheten for et hopp er å endre modellen.
Fra den nye regelen til PageRank
La nå \(S\) være lenkematrisen for nettverket vi undersøker; i forsøket er det matrisen med fellen på D. For en sannsynlighetsvektor \(p_k\) blir neste fordeling
\[p_{k+1}=\underbrace{\alpha Sp_k}_{\text{lenkeklikk}}+ \underbrace{(1-\alpha)u}_{\text{tilfeldige hopp}}.\]
I prosjekt 5 kaller vi denne oppdateringen \(T(p)=\alpha Sp+(1-\alpha)u\). Der betyr \(T\) altså «ett steg med lenker og hopp», ikke den lineære transformasjonen \(T(x)=Ax\) fra 5.1.
En side uten utgående lenker, en hengende node, får \(u\) som sin kolonne i \(S\), slik at \(S\) alltid er kolonnestokastisk (se fordypningen «utled Google-matrisen»).
For et nettverk med \(n\) sider velger vi en fast hoppfordeling \(u\) med \(n\) koordinater og lar \(\mathbf1\) være kolonnen med \(n\) ettall. Matrisen \(u\mathbf1^T\) har hoppfordelingen \(u\) i hver kolonne, fordi hoppene har samme fordeling fra alle avsendersider. Den samlede overgangsmatrisen er derfor
\[G=\alpha S+(1-\alpha)u\mathbf1^T,\qquad p_{k+1}=Gp_k.\]
Fordi \(p\) har sum én, er \((u\mathbf1^T)p=u(\mathbf1^Tp)=u\). Derfor gir \(Gp=\alpha Sp+(1-\alpha)u\) akkurat regelen over. \(G\) kalles Google-matrisen. Dens stasjonære sannsynlighetsvektor \(p_*\) er PageRank-vektoren:
\[Gp_*=p_*,\qquad p_{*,i}\geq0,\qquad \sum_i p_{*,i}=1.\]
Elementene er sidenes PageRank-verdier, som vi rangerer fra størst til minst. Også her bruker vi fikspunktiterasjon fra uke 2: \(p_{k+1}=Gp_k\). Fikspunktresidualen er \(Gp-p\), forskjellen mellom neste og nåværende fordeling. Spørsmålet er nå om iterasjonen nærmer seg samme fikspunkt fra alle startfordelinger.
Hvorfor får vi nå én bestemt rangering?
Anta at \(S\) er kolonnestokastisk, at \(u_i>0\) for alle sider, at \(\sum_i u_i=1\), og at \(0<\alpha<1\). Da er alle elementene i \(G\) positive, og hver kolonne summerer til én. Perron–Frobenius-teoremet gir da det vi trenger: Det finnes nøyaktig én stasjonær sannsynlighetsvektor, alle elementene er positive (fordi \(p_*=\alpha Sp_*+(1-\alpha)u\) har hvert element minst \((1-\alpha)u_i>0\)), og \(G^kp_0\) konvergerer mot den fra enhver startfordeling \(p_0\). Dette krever verken symmetri eller en egenvektorbasis.
Grunnen er at hvert steg med \(G\) krymper avstanden mellom to fordelinger med minst faktor \(\alpha\), målt i 1-normen \(\lVert z\rVert_1=\sum_i|z_i|\) (se fordypningen «en feilgrense uten en egenvektorbasis»). Da kan følgene fra to forskjellige startfordelinger ikke holde seg adskilt, og det finnes bare én stasjonær fordeling.
Hvor nær er vi? I 1-normen gjelder feilgrensen
\[\lVert p-p_*\rVert_1\le\frac{\lVert Gp-p\rVert_1}{1-\alpha}.\]
Liten residual gir altså liten feil, men nær \(\alpha=1\) må residualen være mye mindre. Utledningen står i fordypningen «en feilgrense uten en egenvektorbasis». Grensen brukes som stoppkrav i prosjekt 5.
Diskuter: Ved \(\alpha=0\) velges alle sider etter \(u\), og ved \(\alpha=1\) mister vi garantien. Kan en rangering være entydig og lett å beregne, men likevel lite relevant for det en bruker leter etter?
Svaret på ukens spørsmål
Vi spurte hva som overlever når vi ganger med den samme matrisen om og om igjen. Nå kan vi svare:
- Skriv startvektoren som en sum av bidrag langs egenvektorene. I hvert steg ganges hvert bidrag med sin egenverdi.
- Bidraget med størst egenverdi i absoluttverdi vokser raskest i forhold til de andre. Det bestemmer retningen etter mange steg, så sant det var med fra start. Forholdet \(|\lambda_2/\lambda_1|\) bestemmer farten.
- Potensmetoden bruker dette til å finne en egenvektor, og Rayleigh-kvotienten gir egenverdien.
- I PageRank er det som overlever den stasjonære fordelingen: en egenvektor med egenverdi 1. Tilfeldige hopp gjør at avviket fra den krymper med minst faktor \(\alpha\) per steg, så rangeringen blir den samme uansett hvor den besøkende starter.
I prosjekt 5 undersøker du hvor mye besøksmønsteret må endres før to sider bytter plass.
Øv på dette: tilfeldige hopp, og gå deretter til prosjekt 5.
Gå i dybden: utled Google-matrisen
Produktet av kolonnen \(u\) og raden \(\mathbf1^T\) er en \(n\times n\)-matrise:
\[u\mathbf1^T=\begin{bmatrix}u&u&\cdots&u\end{bmatrix}.\]
Siden \(p_k\) har sum én, får vi
\[(u\mathbf1^T)p_k=u(\mathbf1^Tp_k)=u.\]
Dermed blir \(Gp_k=\alpha Sp_k+(1-\alpha)u\), som er akkurat den nye besøksregelen. I fellen med \(\alpha=0.85\) og jevn hoppfordeling blir D-regelen for eksempel
\[p_D^{(k+1)} =0.85\bigl(\tfrac12p_C^{(k)}+p_D^{(k)}\bigr)+0.0375.\]
Under forutsetningene i teoremet er hvert element positivt:
\[G_{ij}=\alpha S_{ij}+(1-\alpha)u_i>0.\]
Kolonnesummene er
\[\sum_i G_{ij} =\alpha\underbrace{\sum_i S_{ij}}_{1} +(1-\alpha)\underbrace{\sum_i u_i}_{1}=1.\]
På en hengende node finnes ingen lenke å velge. Vi bruker derfor \(u\) også når den besøkende er på en slik side og skulle ha fulgt en lenke. Hvis en hengende node hadde beholdt en nullkolonne i \(S\), ville den tilsvarende kolonnen i \(G\) summert til \(1-\alpha\). Derfor erstatter vi nullkolonnen med \(u\) før vi danner \(G\).
Ved stasjonaritet kan vi flytte ledd og få et lineært system:
\[p_*=\alpha Sp_*+(1-\alpha)u \quad\Longleftrightarrow\quad (I-\alpha S)p_*=(1-\alpha)u.\]
På små nettverk kan dette brukes som en uavhengig kontroll av iterasjonen. På store nettverk beregner vi \(\alpha Sp+(1-\alpha)u\) direkte; vi trenger ikke lagre den tette matrisen \(u\mathbf1^T\).
Gå i dybden: egenverdier forklarer pendling og avtagende avvik
Her ser vi hvordan egenverdiene forklarer pendlingen, i et konkret eksempel med to sider som bare lenker til hverandre. Uten hopp blir fordelingen fra sikker start på første side \((1,0)^T,(0,1)^T,(1,0)^T,\ldots\). Fordelingen \((1/2,1/2)^T\) er stasjonær, men denne følgen nærmer seg den ikke.
Med jevn hoppfordeling og \(\alpha=\tfrac12\) (halvparten lenkeklikk, halvparten hopp) får vi
\[G=\tfrac12\begin{bmatrix}0&1\\1&0\end{bmatrix} +\tfrac12\begin{bmatrix}1/2&1/2\\1/2&1/2\end{bmatrix} =\begin{bmatrix}1/4&3/4\\3/4&1/4\end{bmatrix}.\]
For \(v=(1,1)^T\) og \(w=(1,-1)^T\) er
\[Gv=\begin{bmatrix}1/4+3/4\\3/4+1/4\end{bmatrix}=v,\qquad Gw=\begin{bmatrix}1/4-3/4\\3/4-1/4\end{bmatrix}=\begin{bmatrix}-1/2\\1/2\end{bmatrix}=-\tfrac12w.\]
Den stasjonære fordelingen er \(p_*=v/2=(1/2,1/2)^T\). Fra \(p_0=(1,0)^T=(v+w)/2\) får vi, fordi hvert steg ganger \(w\)-bidraget med \(-\tfrac12\),
\[p_k=\tfrac12v+\tfrac12\bigl(-\tfrac12\bigr)^kw,\qquad p_1=\begin{bmatrix}1/4\\3/4\end{bmatrix},\quad p_2=\begin{bmatrix}5/8\\3/8\end{bmatrix}.\]
Fortegnet på avviket veksler, men størrelsen halveres i hvert steg. Dette knytter besøksmodellen til fortegnsforsøket i 5.4. I prosjekt 5 gjør du den samme analysen for en vilkårlig \(\alpha\), og undersøker hva som skjer når hoppene fjernes.
Gå i dybden: en feilgrense uten en egenvektorbasis
Vi bruker normen \(\lVert z\rVert_1=\sum_i|z_i|\). Fordi \(S\) har ikke-negative elementer og kolonnesum én, gir trekantulikheten \(|a+b|\le|a|+|b|\)
\[\begin{aligned} \lVert Sz\rVert_1 &=\sum_i\left|\sum_j S_{ij}z_j\right|\\ &\leq\sum_j|z_j|\underbrace{\sum_iS_{ij}}_{1} =\lVert z\rVert_1. \end{aligned}\]
Hvis \(Sz=\lambda z\) med \(z\ne0\), gir dette \(|\lambda|\,\lVert z\rVert_1\le\lVert z\rVert_1\), altså \(|\lambda|\le1\): egenverdiene til en kolonnestokastisk matrise har absoluttverdi høyst én.
La \(z\) være en vektor med sum null, \(\mathbf1^Tz=0\), for eksempel forskjellen mellom to sannsynlighetsvektorer. Da er \((u\mathbf1^T)z=u(\mathbf1^Tz)=0\), så \(Gz=\alpha Sz\) og
\[\lVert Gz\rVert_1\le\alpha\lVert z\rVert_1.\]
Ett steg med \(G\) krymper altså avstanden mellom to fordelinger med minst faktor \(\alpha\). Etter \(k\) steg er avstanden høyst \(\alpha^k\) ganger den opprinnelige.
Vi får også en kontroll som ikke krever at vi kjenner \(p_*\). La \(p\) være en sannsynlighetsvektor, \(e=p-p_*\) og \(r=Gp-p\). Siden \(Gp_*=p_*\), er \(Ge=Gp-p_*=r+e\), altså \(e=-r+Ge\). Fordi \(e\) har sum null, er \(\lVert Ge\rVert_1\leq\alpha\lVert e\rVert_1\), og
\[\lVert e\rVert_1\leq\lVert r\rVert_1+\alpha\lVert e\rVert_1 \quad\Longrightarrow\quad \boxed{\lVert p-p_*\rVert_1\leq \frac{\lVert Gp-p\rVert_1}{1-\alpha}}.\]
Her er \(0\leq\alpha<1\). Nær \(\alpha=1\) må residualen være mindre for å garantere samme feil. Med \(\lVert r\rVert_1=10^{-8}\) er feilgrensen omtrent \(6.67\cdot10^{-8}\) ved \(\alpha=0.85\), men \(10^{-6}\) ved \(\alpha=0.99\).
De to oppgavene her repeterer verktøy fra Matematikk 1. Bruk dem som selvtest dersom lineære systemer, egenverdier eller egenvektorer ikke sitter friskt. Du trenger ikke fullføre støtteløpet dersom forkunnskapene sitter; gå da direkte til 5.8 Hovedløp.
Arbeid først på papir og bruk svarfeltene til å kontrollere regningen. Bruk eksakte tall, for eksempel 3/2 og sqrt(2). Skriftlige begrunnelser føres i egne notater.
Koordinater i en egenvektorbasis
Vi har \(v_1=(1,1)^T\), \(v_2=(1,-1)^T\) og \(x=(2,1)^T\), og vil finne tallene \(c_1,c_2\) slik at \(x=c_1v_1+c_2v_2\). Skriv først én likning for hver koordinat i egne notater, og løs deretter systemet. Skriv ett tall i hvert felt.
Kontroller og tolk: Beregn \(c_1v_1+c_2v_2\), og forklar hvorfor \(c_1,c_2\) ikke er de samme som standardkoordinatene \(2,1\).
Hint: koordinater i en egenvektorbasis
Likningene er \(c_1+c_2=2\) og \(c_1-c_2=1\). Hva skjer når du legger dem sammen?
Egenverdier og egenvektorer for hånd
Vi undersøker \(A=\begin{bmatrix}1&2\\2&1\end{bmatrix}\). Sett opp \(\det(A-\lambda I)=0\) i egne notater og løs likningen. Løs deretter \((A-\lambda I)v=0\) for hver egenverdi. Du velger selv skaleringen av egenvektorene. Skriv den største egenverdien først; kontrollen av egenvektorene sjekker bare at \(Av=\lambda v\).
Beskriv alle valgene: Bruk de to egenvektorene dine til å beskrive alle egenvektorene til hver egenverdi og de to egenrommene, som parameterfamilier \(tv_i\). Hvilket vilkår på \(t\) gjelder for egenvektorer, og hvilket for egenrom? Hva gjør den negative egenverdien med retningen?
Hint: egenverdier og egenvektorer
Determinantlikningen er \((1-\lambda)^2-4=0\), altså \(1-\lambda=\pm2\). Sett hver rot inn i \(A-\lambda I\) og løs det homogene systemet. Matrisen er singulær, så du skal ikke forsøke å invertere den.
Oppgavene her bruker ukens nye ideer i Matematikk 3A: utvikling i en egenvektorbasis, potensmetoden og PageRank. Dette er hovedløpet. Hvis du trenger repetisjon av lineære systemer, egenverdier eller egenvektorer, bruk 5.7 Støtteløp og kom tilbake hit.
Hver oppgave angir hva du skal levere: tall i svarfeltene, kode i kodevinduet eller begrunnelser i egne notater. Bruk eksakte tall i matematikkfeltene, for eksempel 3/2 og sqrt(2).
Gjentatt transformasjon i en egenvektorbasis
Vi undersøker en ny transformasjon, representert ved
\[B=\begin{bmatrix}2&2\\2&5\end{bmatrix},\qquad x_0=(3,1)^T.\]
Du får oppgitt egenvektorene \(w_1=(1,2)^T\) og \(w_2=(2,-1)^T\), med henholdsvis egenverdiene \(6\) og \(1\). Bestem først \(c_1,c_2\) fra \(x_0=c_1w_1+c_2w_2\), og bruk deretter \(B^kx_0=c_1 6^k w_1+c_2 1^k w_2\). Skriv de to standardkoordinatene til \(B^kx_0\) som uttrykk i \(k\), for eksempel med 6^k.
Hint: gjentatt transformasjon i en egenvektorbasis
Løs \(c_1(1,2)^T+c_2(2,-1)^T=(3,1)^T\) koordinat for koordinat. Sett deretter \(c_1,c_2\) inn i \(B^kx_0=c_16^kw_1+c_2w_2\) og les av første og andre koordinat.
Sett inn \(k=3\). De to første feltene under er standardkoordinatene til \(B^3x_0\). Det siste feltet er ett ikke-negativt tall: lengden av bidraget langs \(w_2\) delt på lengden av bidraget langs \(w_1\),
\[\frac{\lVert c_2 1^3 w_2\rVert_2}{\lVert c_1 6^3 w_1\rVert_2}.\]
La nå \(R_k\) være det samme forholdet etter \(k\) steg:
\[R_k=\frac{\lVert c_2 1^k w_2\rVert_2}{\lVert c_1 6^k w_1\rVert_2}.\]
Finn et uttrykk for \(R_k\), grenseverdien når \(k\to\infty\), og lengden av det andre bidraget. Bruk de samme \(c_1,c_2\) som over.
Forklar: Bruk svarene til å forklare i egne notater hvorfor de normaliserte vektorene nærmer seg linjen gjennom \(w_1\), selv om det andre bidraget ikke blir kortere.
Finn så en ikke-null startvektor som gir en iterasjonsfølge som ikke nærmer seg linjen gjennom \(w_1\). Skriv to konkrete koordinater; alle gyldige skaleringer godtas.
Begrunn i egne notater hvorfor vektoren din har den ønskede egenskapen.
Til slutt endrer vi fortegnet på én egenverdi. Behold \(x_0=(3,1)^T\) og basisvektorene, men la den nye transformasjonen \(\widetilde B\) ha egenverdiene \(6\) og \(-1\). Skriv de to standardkoordinatene til \(\widetilde B^kx_0\) som uttrykk i \(k\). Bruk parenteser i (-1)^k.
Sammenlign: Hva endres ved fortegnet og lengden til det andre bidraget? Begrunn svaret i egne notater.
Ett steg av potensmetoden for hånd
Vi bruker \(A=\begin{bmatrix}3&1\\1&3\end{bmatrix}\) og startvektoren \(x_0=(1,0)^T\). Regn ut Rayleigh-kvotienten \(\rho(x_0)\) og lengden av egenresidualen \(r_0=Ax_0-\rho(x_0)x_0\). Gjør så ett steg av potensmetoden, \(x_1=Ax_0/\lVert Ax_0\rVert_2\), og regn ut det samme for \(x_1\). Skriv eksakte tall, for eksempel 18/5.
Tolk: Egenverdiene til \(A\) er \(4\) og \(2\). Hvilken av dem nærmer \(\rho\) seg, og hva skjer med residualen? Kontroller at \(x_1^Tr_1=0\).
Hint: ett steg av potensmetoden
\(Ax_0=(3,1)^T\), så \(x_1=(3,1)^T/\sqrt{10}\). Siden \(x_1\) har lengde én, er \(\rho(x_1)=x_1^TAx_1\). Regn ut \(Ax_1\) først.
Hva kontrollerer en liten egenresidual?
Nå programmerer du potensmetoden. Fullfør power_check: normaliser startvektoren og utfør deretter nøyaktig steps oppdateringer \(x\leftarrow Ax/\lVert Ax\rVert_2\). Beregn til slutt
\[\rho=\frac{x^TAx}{x^Tx},\qquad r=Ax-\rho x.\]
| Navn | Type og betydning |
|---|---|
A |
Reell NumPy-matrise med form (n, n) |
start |
Reell NumPy-vektor med form (n,), forskjellig fra null |
steps |
Heltall større enn eller lik null |
| Returverdi | Tuple (x, rho, residual) |
x |
NumPy-vektor med form (n,) og lengde én |
rho |
Reell skalar: Rayleigh-kvotienten for siste vektor |
residual |
Ikke-negativ skalar: \(\lVert r\rVert_2\) |
Du kan anta at ingen multiplikasjon gir nullvektoren. Når steps=0, skal funksjonen fortsatt normalisere startvektoren og beregne de to skalarene.
Sammenlign tre startvektorer: Bruk \(A=\operatorname{diag}(5,2)\) og \((1,1)^T\), \((0,1)^T\), \((10^{-8},1)^T\). Forutsi hvilke som vil gi tilnærming til egenverdien \(5\), og hvilken som vil gi raskest tilnærming. Prøv deretter 5, 20 og 40 steg for hver startvektor. Legg egne funksjonskall før ## TESTS ## i kodevinduet, og lag en tabell med startvektor, antall steg, \(\rho\) og residualens lengde.
Tolk kontrollen: Kan residualen være null når \(\rho=2\)? Hva bekrefter en null residual, og hva sier den ikke om størrelsen på egenverdien? Bruk uttrykket for \(A^kx_0\) til å forklare forskjellen mellom startvektorene \((0,1)^T\) og \((10^{-8},1)^T\), med én vektorformel og en kort konklusjon.
Stasjonær fordeling for tre sider
Tre nettsider lenker slik: A lenker til B og C, B lenker til C, og C lenker til A. Den besøkende velger en av lenkene med lik sannsynlighet. Skriv overgangsmatrisen \(S\) i egne notater, med kolonnene som sidene vi går fra og rekkefølgen A, B, C. Regn så ut ett steg fra jevn startfordeling \(p_0=(1/3,1/3,1/3)^T\), og finn den stasjonære fordelingen \(p_*\) med sum én.
Kontroller: Har \(Sp_0\) sum én? Sett \(p_*\) inn i \(Sp=p\) og sjekk alle tre radene. Hvilken side rangeres lavest, og hvorfor, ut fra lenkene?
Hint: stasjonær fordeling
Gå fram som i håndeksempelet i 5.5: skriv én likning per rad i \(S\), start med den enkleste, og uttrykk alle andelene ved \(p_A\). Bruk kravet «sum én» til slutt.
Stasjonær fordeling uten konvergens
To nettsider lenker bare til hverandre. Overgangsmatrisen er \(S=\begin{bmatrix}0&1\\1&0\end{bmatrix}\), med kolonner som avsendersider. Løs \(Sp_*=p_*\) sammen med \(p_{*,1}+p_{*,2}=1\), og finn begge egenverdiene til \(S\). Skriv de to sannsynlighetene og egenverdien som ikke er \(1\).
Følg to startfordelinger: Finn \(p_0,p_1,p_2,p_3\) både når \(p_0=(1,0)^T\) og når \(p_0=p_*\).
Forklar forskjellen: Bruk den andre egenverdien til å forklare hvorfor en entydig stasjonær fordeling ikke sikrer konvergens fra enhver startfordeling. Knytt forklaringen til vektorene du fant.
Hint: stasjonær fordeling uten konvergens
Skriv \(Sp=p\) som to likninger, én per rad. Egenverdiene finner du fra \(\det(S-\lambda I)=\lambda^2-1=0\). For følgene: \(S\) bytter de to koordinatene, så bruk den regelen tre ganger.
Tilfeldige hopp endrer forløp og rangering
Vi følger lenkene med sannsynlighet \(\alpha\) og velger ellers neste side etter en fast sannsynlighetsvektor \(u\). Oppdateringen er \(p_{k+1}=\alpha Sp_k+(1-\alpha)u\). Fullfør visit_step, som gjør ett slikt steg.
| Navn | Type og betydning |
|---|---|
S |
NumPy-matrise med form (n, n), ikke-negative elementer og kolonnesum én |
alpha |
Reell skalar med \(0\leq\alpha<1\) |
u, p |
NumPy-vektorer med form (n,), ikke-negative elementer og sum én |
| Returverdi | NumPy-vektor med form (n,): fordelingen etter ett steg |
Bruk nøyaktig denne rekkefølgen på argumentene, fordi du bruker den samme funksjonen i prosjekt 5, del 2. Funksjonen skal returnere vektoren, ikke skrive den ut eller returnere flere verdier.
Undersøk farten: Bruk \(S=\begin{bmatrix}0&1\\1&0\end{bmatrix}\), \(u=(1/2,1/2)^T\) og \(p_0=(1,0)^T\). Velg to verdier \(0<\alpha<1\) som du tror vil gi tydelig forskjellig konvergensfart, med samme startfordeling og antall steg i begge forsøk. Lag ett plott av \(\lVert p_k-u\rVert_2\) mot \(k\) med én merket kurve for hver verdi av \(\alpha\), og sammenlign med forventningen din. Legg forsøkskoden før ## TESTS ##.
Nå bytter vi til en skjev hoppfordeling \(u=(0.8,\,0.2)^T\) og \(\alpha=\tfrac12\), fortsatt med de to sidene som lenker til hverandre. Finn den stasjonære fordelingen \(p_*\) ved å løse \(p_*=\tfrac12Sp_*+\tfrac12u\) for hånd. Skriv deretter avviket \(e_k=p_k-p_*\) som et tall ganger \((1,-1)^T\), og finn faktoren som dette tallet ganges med i hvert steg.
Begrunn: Skriv \(e_k\) som en formel i \(k\) når \(p_0=(1,0)^T\), og forklar både fortegnet og farten. Hvorfor er \(p_*\) ikke lik \(u\) her?
Hint: skjeve hopp
Med \(S=\begin{bmatrix}0&1\\1&0\end{bmatrix}\) blir \(p_*=\tfrac12Sp_*+\tfrac12u\) til de to likningene \(p_1=\tfrac12p_2+0.4\) og \(p_2=\tfrac12p_1+0.1\). Regn så ut \(p_1\) og \(p_2\) fra \(p_0=(1,0)^T\) og sammenlign avvikene \(e_0,e_1,e_2\).
Skill regnefart fra modellvalg: Forklar hva en lavere \(\alpha\) betyr for vekten på lenkene. I det symmetriske eksemplet med \(u=(1/2,1/2)^T\) er den stasjonære fordelingen \(u\) for alle \(0\leq\alpha<1\). Hvorfor betyr ikke dette at rangeringen på andre nettverk er uavhengig av \(\alpha\)? Bruk fellen i 5.6 som sammenligningsgrunnlag.
I prosjekt 5 bruker du dette til en egen undersøkelse av rangering. Skill mellom tre spørsmål: Oppfyller svaret likningen? Konvergerer metoden? Måler modellen det vi ønsket?